La arquitectura de la generación aumentada por recuperación (RAG) en ecosistemas B2B
La Generación Aumentada por Recuperación, o RAG, ha surgido como el estándar definitivo para las empresas que buscan aprovechar los Large Language Models (LLMs) sin los riesgos inherentes de alucinaciones de datos o información desactualizada. Mientras que los modelos fundacionales como GPT-4 o Claude 3.5 Sonnet son increíblemente capaces, son esencialmente instantáneas estáticas de información. Para una entidad B2B, confiar en un modelo que no conoce su inventario actual en Shopify o su documentación de servicio más reciente en WordPress es una receta para el fracaso operativo. RAG soluciona esto proporcionando al modelo una "biblioteca de búsqueda" de sus datos privados, la cual consulta antes de generar una respuesta. Este proceso garantiza que cada salida esté fundamentada en hechos verificables y en tiempo real específicos de su organización.
En el núcleo técnico de un sistema RAG se encuentra el concepto de vector embeddings. Cuando ingerimos datos del ecosistema de un cliente —ya sea documentación técnica de un Webflow CMS o especificaciones de productos complejas de una tienda WooCommerce— no solo pegamos texto en un prompt. Transformamos esos datos en vectores numéricos de alta dimensión utilizando modelos de embedding. Estos vectores se almacenan luego en una base de datos vectorial especializada, como Pinecone, Weaviate o una instancia de PGVector autohospedada. Cuando un usuario o un agente automatizado hace una pregunta, el sistema convierte esa consulta en un vector, encuentra los "fragmentos" (chunks) de datos matemáticamente más similares en la base de datos y entrega esos fragmentos específicos al LLM como contexto. Esto permite que el agente actúe como un experto altamente especializado en su lógica de negocio específica, manteniendo un nivel de precisión que la IA genérica simplemente no puede igualar.
Implementar RAG a nivel empresarial requiere una comprensión sofisticada de las estrategias de data chunking y metadatos. No basta con simplemente subir un PDF. En werun.dev, nos enfocamos en el semantic chunking: desglosar la información en segmentos lógicos que preserven el contexto. Por ejemplo, si estamos indexando la política de devoluciones de una tienda Shopify Plus, nos aseguramos de que las condiciones, los plazos y las excepciones se mantengan dentro de la misma ventana de contexto. Además, adjuntamos metadatos a estos fragmentos, como marcas de tiempo de "última actualización" o etiquetas de "categoría de producto". Esto permite que el motor de recuperación filtre la información dinámicamente. Si un agente está ayudando a un cliente con una línea de productos específica, el sistema puede priorizar los fragmentos de datos etiquetados con ese ID específico, reduciendo drásticamente el ruido y aumentando la precisión del resultado final. Este rigor arquitectónico es lo que separa a un chatbot básico de un agente inteligente de grado profesional capaz de manejar interacciones B2B de alto nivel.
Más allá de la precisión, RAG proporciona una capa crítica de seguridad y cumplimiento. Al utilizar un enfoque basado en la recuperación, las empresas pueden mantener sus datos sensibles dentro de su propio entorno controlado. En lugar de realizar un fine-tuning de un modelo —lo que efectivamente integra los datos en los pesos del modelo y dificulta su eliminación— RAG permite el "hot-swapping" de datos. Si un documento queda obsoleto o un producto se descontinúa, simplemente se elimina de la base de datos vectorial y el agente de IA pierde el acceso a él de inmediato. Este nivel de control granular es esencial para industrias con requisitos regulatorios estrictos, garantizando que la IA nunca proporcione información no autorizada o desactualizada a los usuarios. Al conectar sus bases de datos existentes a estas capas inteligentes, transforma los datos pasivos en un activo conversacional activo que escala con el crecimiento de su negocio.
Cerrando la brecha: conectando bases de datos de CMS y e-commerce con agentes de IA
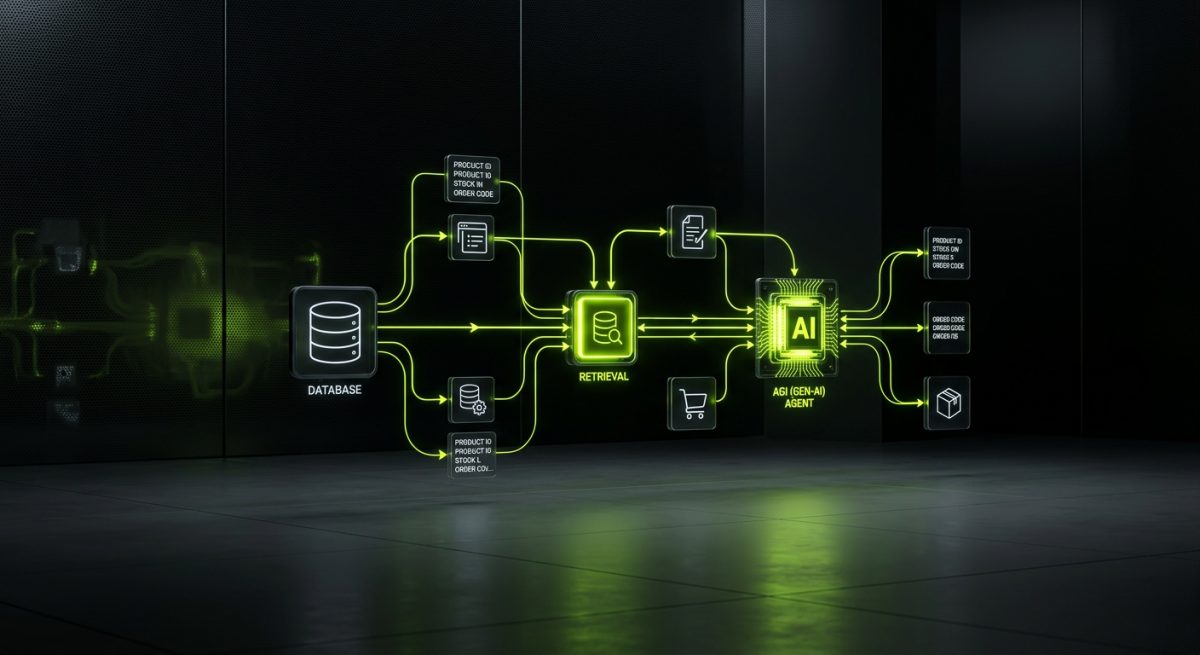
El verdadero poder de un agente inteligente se materializa cuando se integra perfectamente con sus fuentes primarias de verdad: sus plataformas de CMS y E-commerce. Para muchos de nuestros clientes, esto significa conectar una capa de IA a WordPress, Webflow o Shopify. El desafío radica en que estas plataformas almacenan datos en bases de datos relacionales estructuradas o formatos propietarios que los LLMs no pueden "leer" de forma nativa en tiempo real. Para cerrar esta brecha, construimos pipelines de ETL (Extract, Transform, Load) robustos que sincronizan sus datos operativos con los almacenes vectoriales utilizados por los agentes de IA. Esto asegura que el "conocimiento" del agente nunca esté más de unos pocos minutos por detrás del estado real de su negocio.
En el contexto de WordPress, esto a menudo implica el desarrollo de endpoints de la REST API personalizados o la utilización de WP-Cron para activar sincronizaciones de datos. Cuando se publica una nueva guía técnica o se actualiza una página de documentación de un plugin, un webhook activa un flujo de trabajo de n8n. Este flujo de trabajo obtiene el contenido actualizado, limpia el HTML para eliminar el código innecesario, genera nuevos embeddings y actualiza la base de datos vectorial. Este pipeline automatizado elimina la necesidad de entrada manual de datos y garantiza que el agente de IA siempre trabaje con la versión más reciente de la verdad. En werun.dev, priorizamos la construcción de estas integraciones utilizando estándares profesionales, incorporando nonces para seguridad, sanitización adecuada y lógica de manejo de errores para asegurar que la sincronización siga siendo confiable incluso bajo cargas pesadas del servidor. Esto es particularmente vital para entornos WooCommerce donde la disponibilidad de productos y los precios cambian con frecuencia.
Los entornos de Shopify presentan un conjunto diferente de oportunidades, particularmente con la llegada de los Metaobjects y Metafields. Estos tipos de datos estructurados son candidatos perfectos para la integración con RAG. Al mapear los Metaobjects de Shopify a atributos vectoriales específicos, podemos construir agentes que comprendan las intrincadas relaciones entre productos, piezas y requisitos de compatibilidad. Por ejemplo, un comerciante de Shopify Plus B2B que vende maquinaria industrial puede tener un agente que sepa exactamente qué piezas de repuesto se ajustan a un número de serie específico consultando la estructura de Metaobjects a través de un middleware de n8n. Utilizamos la Shopify GraphQL API para extraer estos datos de manera eficiente, asegurando que solo se procese la información necesaria, lo que optimiza tanto la velocidad como el uso del límite de cuota de la API. Este nivel de integración profunda permite que la IA brinde soporte técnico que es indistinguible de un experto humano que ha memorizado todo el catálogo.
Los despliegues en Webflow requieren un enfoque igualmente personalizado, centrado en la CMS API. Debido a que Webflow se utiliza a menudo para sitios de marketing y generación de leads de alta gama, los agentes de IA que desplegamos allí suelen centrarse en la calificación de leads y explicaciones de servicios. Al conectar el CMS de Webflow a un agente inteligente, podemos asegurar que el agente refleje perfectamente la voz de la marca y las ofertas de servicios descritas en el sitio. Si el equipo de marketing actualiza una descripción de servicio en el Webflow Designer, la automatización de n8n detecta el cambio y actualiza la base de conocimientos del agente automáticamente. Esto crea un unificado ecosistema donde el contenido del sitio web y el agente de IA están siempre en perfecta alineación. Al tratar su CMS como una fuente de datos en vivo en lugar de un repositorio estático, permitimos un nivel de automatización que reduce significativamente la carga operativa manual de mantener la consistencia de la IA en múltiples puntos de contacto digitales.
Orquestando flujos de trabajo autónomos con n8n y agentes con capacidad de tool-calling
Yendo más allá de las simples interacciones de preguntas y respuestas, la próxima frontera en la automatización empresarial es el despliegue de flujos de trabajo "agénticos". A diferencia de un chatbot estándar que solo recupera y resume texto, un agente inteligente equipado con capacidades de tool-calling (o function-calling) puede realizar acciones reales dentro de su stack de software. Al usar n8n como la capa de orquestación, podemos otorgar a un agente de IA la capacidad de interactuar con su CRM, su ERP o sus herramientas de gestión de proyectos. Esto transforma al agente de un informante pasivo en un participante activo en sus procesos de negocio. Cuando un cliente interactúa con un agente construido por werun.dev, ese agente no solo está hablando; está ejecutando lógica que impulsa resultados en el mundo real.
La implementación técnica de estos agentes implica definir "herramientas" (tools) específicas que el LLM puede invocar. Por ejemplo, podríamos definir una herramienta llamada check_order_status que se conecta a una tienda Shopify a través de un webhook de n8n. Cuando un usuario pregunta: "¿Dónde está mi último pedido?", el LLM reconoce la intención, identifica la herramienta necesaria y envía una solicitud JSON estructurada a n8n. El flujo de trabajo de n8n luego ejecuta la llamada a la API real a Shopify, recupera el número de seguimiento y lo devuelve al LLM para que lo formatee en una respuesta amigable. Este bucle permite que el agente maneje tareas complejas de varios pasos que anteriormente requerían intervención humana. La belleza de este enfoque es que el LLM nunca tiene acceso directo a sus claves de API; n8n actúa como una pasarela segura, garantizando que el agente solo pueda realizar las acciones específicas que hemos permitido explícitamente.
El manejo de errores y la confiabilidad son primordiales al desplegar agentes autónomos en un entorno B2B. Diseñamos nuestros flujos de trabajo de n8n con un registro exhaustivo (logging) y lógica de reintento. Si una API externa está caída o una solicitud agota el tiempo de espera, el flujo de trabajo no solo falla; puede activar una alerta en Slack o enviar un correo electrónico al equipo de desarrollo, mientras instruye simultáneamente al agente de IA para que informe al usuario que está ocurriendo un retraso temporal. Este enfoque de automatización de grado profesional garantiza que el sistema sea resiliente y transparente. Además, implementamos puntos de control de "human-in-the-loop" para acciones sensibles. Por ejemplo, un agente podría redactar un reembolso en WooCommerce, pero la ejecución real de ese reembolso podría requerir una aprobación manual a través de un enlace generado por n8n enviado a un administrador. Esto equilibra la eficiencia de la IA con la supervisión necesaria de la experiencia humana.
Finalmente, la integración de RAG con estos flujos de trabajo agénticos crea un potente bucle de retroalimentación. A medida que el agente realiza tareas, también puede registrar los resultados de vuelta en la base de datos, lo que luego se convierte en parte de su contexto futuro. Si un agente resuelve con éxito un problema técnico complejo para un usuario, esa interacción puede resumirse y almacenarse en la base de datos vectorial como un "caso de estudio" para referencia futura. Esto significa que el sistema literalmente se vuelve más inteligente con cada interacción. En werun.dev, nos especializamos en construir estos sistemas de automejora que conectan WordPress, Shopify y Webflow en un todo cohesivo e inteligente. Al aprovechar n8n para conectar APIs y LLMs dispares, ayudamos a las empresas a eliminar cuellos de botella manuales y escalar sus operaciones con un nivel de precisión que era imposible hace solo unos años. El objetivo no es solo automatizar, sino construir una fuerza de trabajo digital que entienda su negocio tan profundamente como usted.